Un projet d’analyse de données pour mieux orienter la surveillance des approvisionnements.
Python · Pandas · Power BI · DAX · Données publiques
Un patient arrive en pharmacie avec son ordonnance. Son médicament n’est pas disponible. Il faut attendre, contacter un professionnel de santé ou rechercher une alternative.
Derrière une rupture de médicament, il y a un traitement qui peut être retardé et une prise en charge qui se complique.
J’ai choisi ce sujet parce que je voulais travailler sur un enjeu concret de santé publique, où l’analyse de données peut aider à orienter les actions.
Ma question était : comment utiliser les données pour aider les équipes Supply Chain à savoir quelles molécules surveiller en premier ?
Un médicament peut faire l’objet de nombreuses déclarations de rupture. Un autre peut être beaucoup plus consommé.
Pour établir des priorités, j’ai donc décidé de comparer la fréquence des déclarations de rupture et le nombre de boîtes remboursées, utilisé comme indicateur de consommation.
L’analyse porte sur les années 2022 à 2024, ce qui permet aussi d’observer les évolutions sur trois années.
Les données existaient dans trois sources publiques :
La difficulté était de retrouver une même molécule dans plusieurs fichiers, alors que les noms pouvaient être écrits différemment.
Avec Python et Pandas, j’ai nettoyé les fichiers, traité les doublons et les valeurs manquantes, puis harmonisé les libellés. J’ai ensuite recherché les correspondances exactes, puis les noms proches à l’aide d’un rapprochement approché.
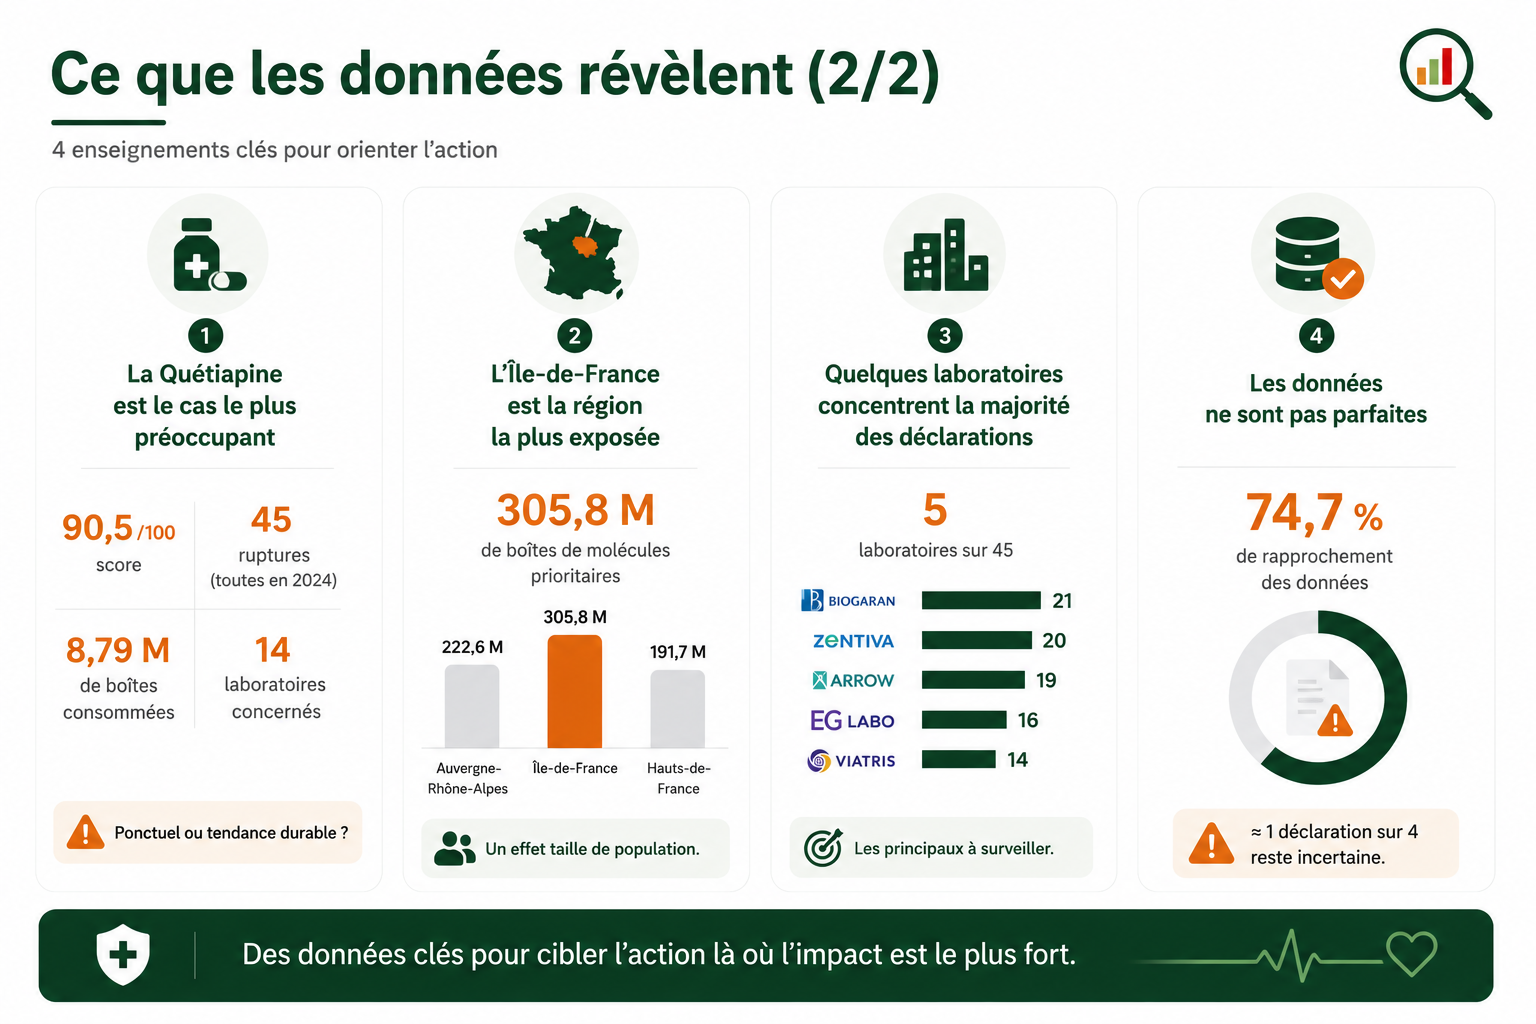
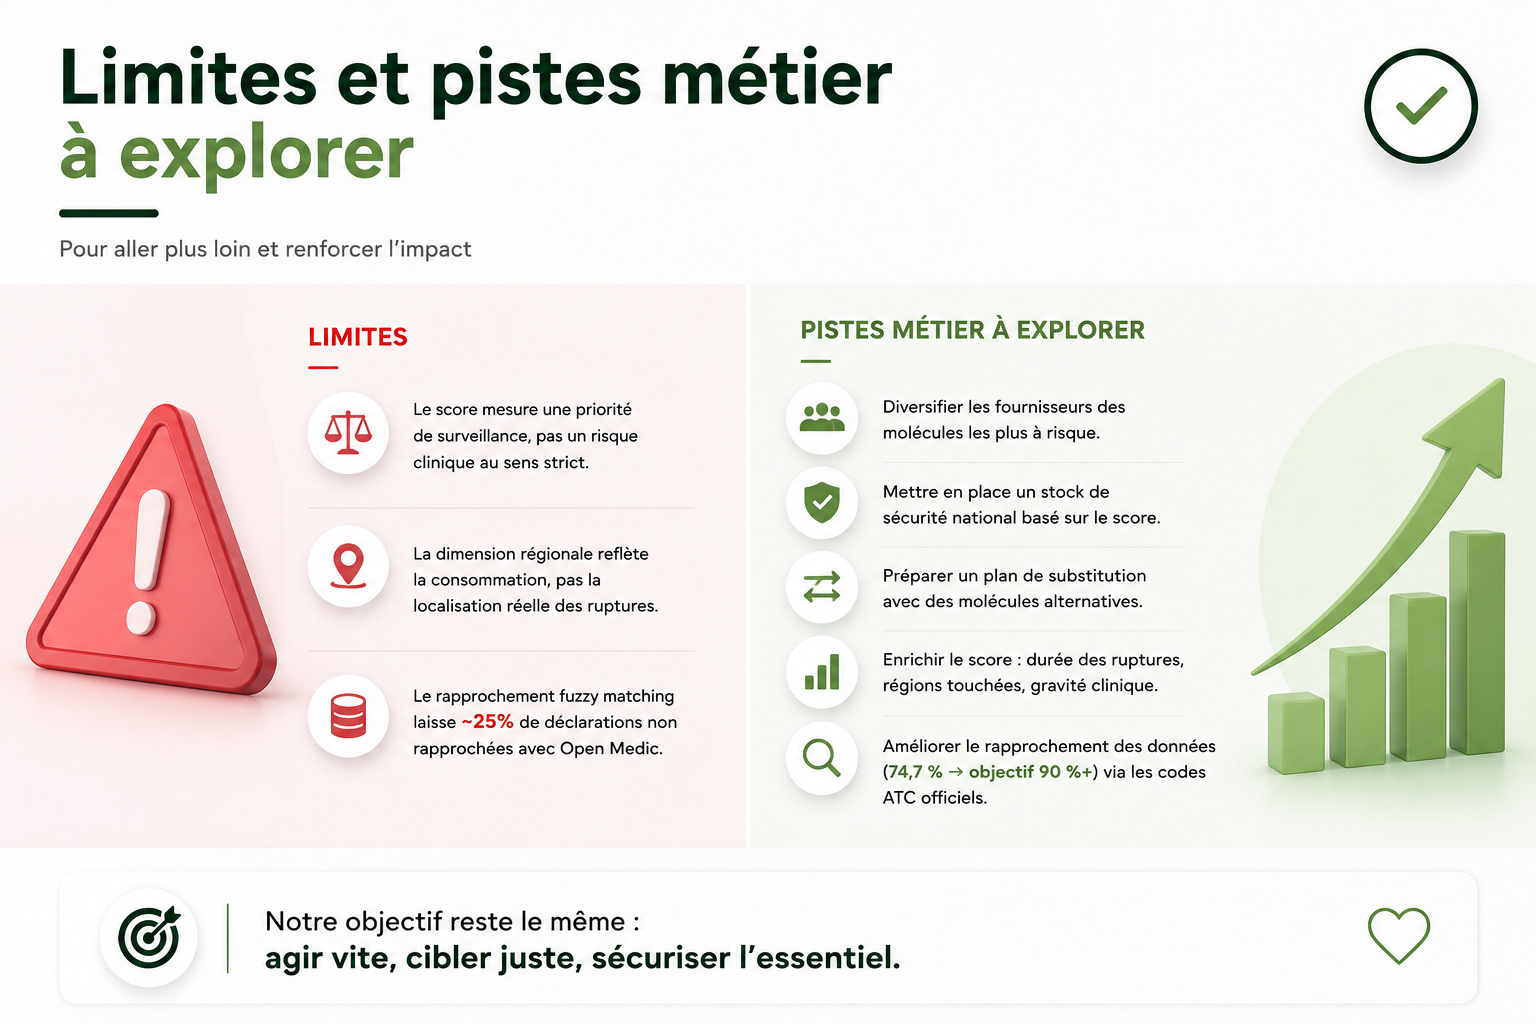
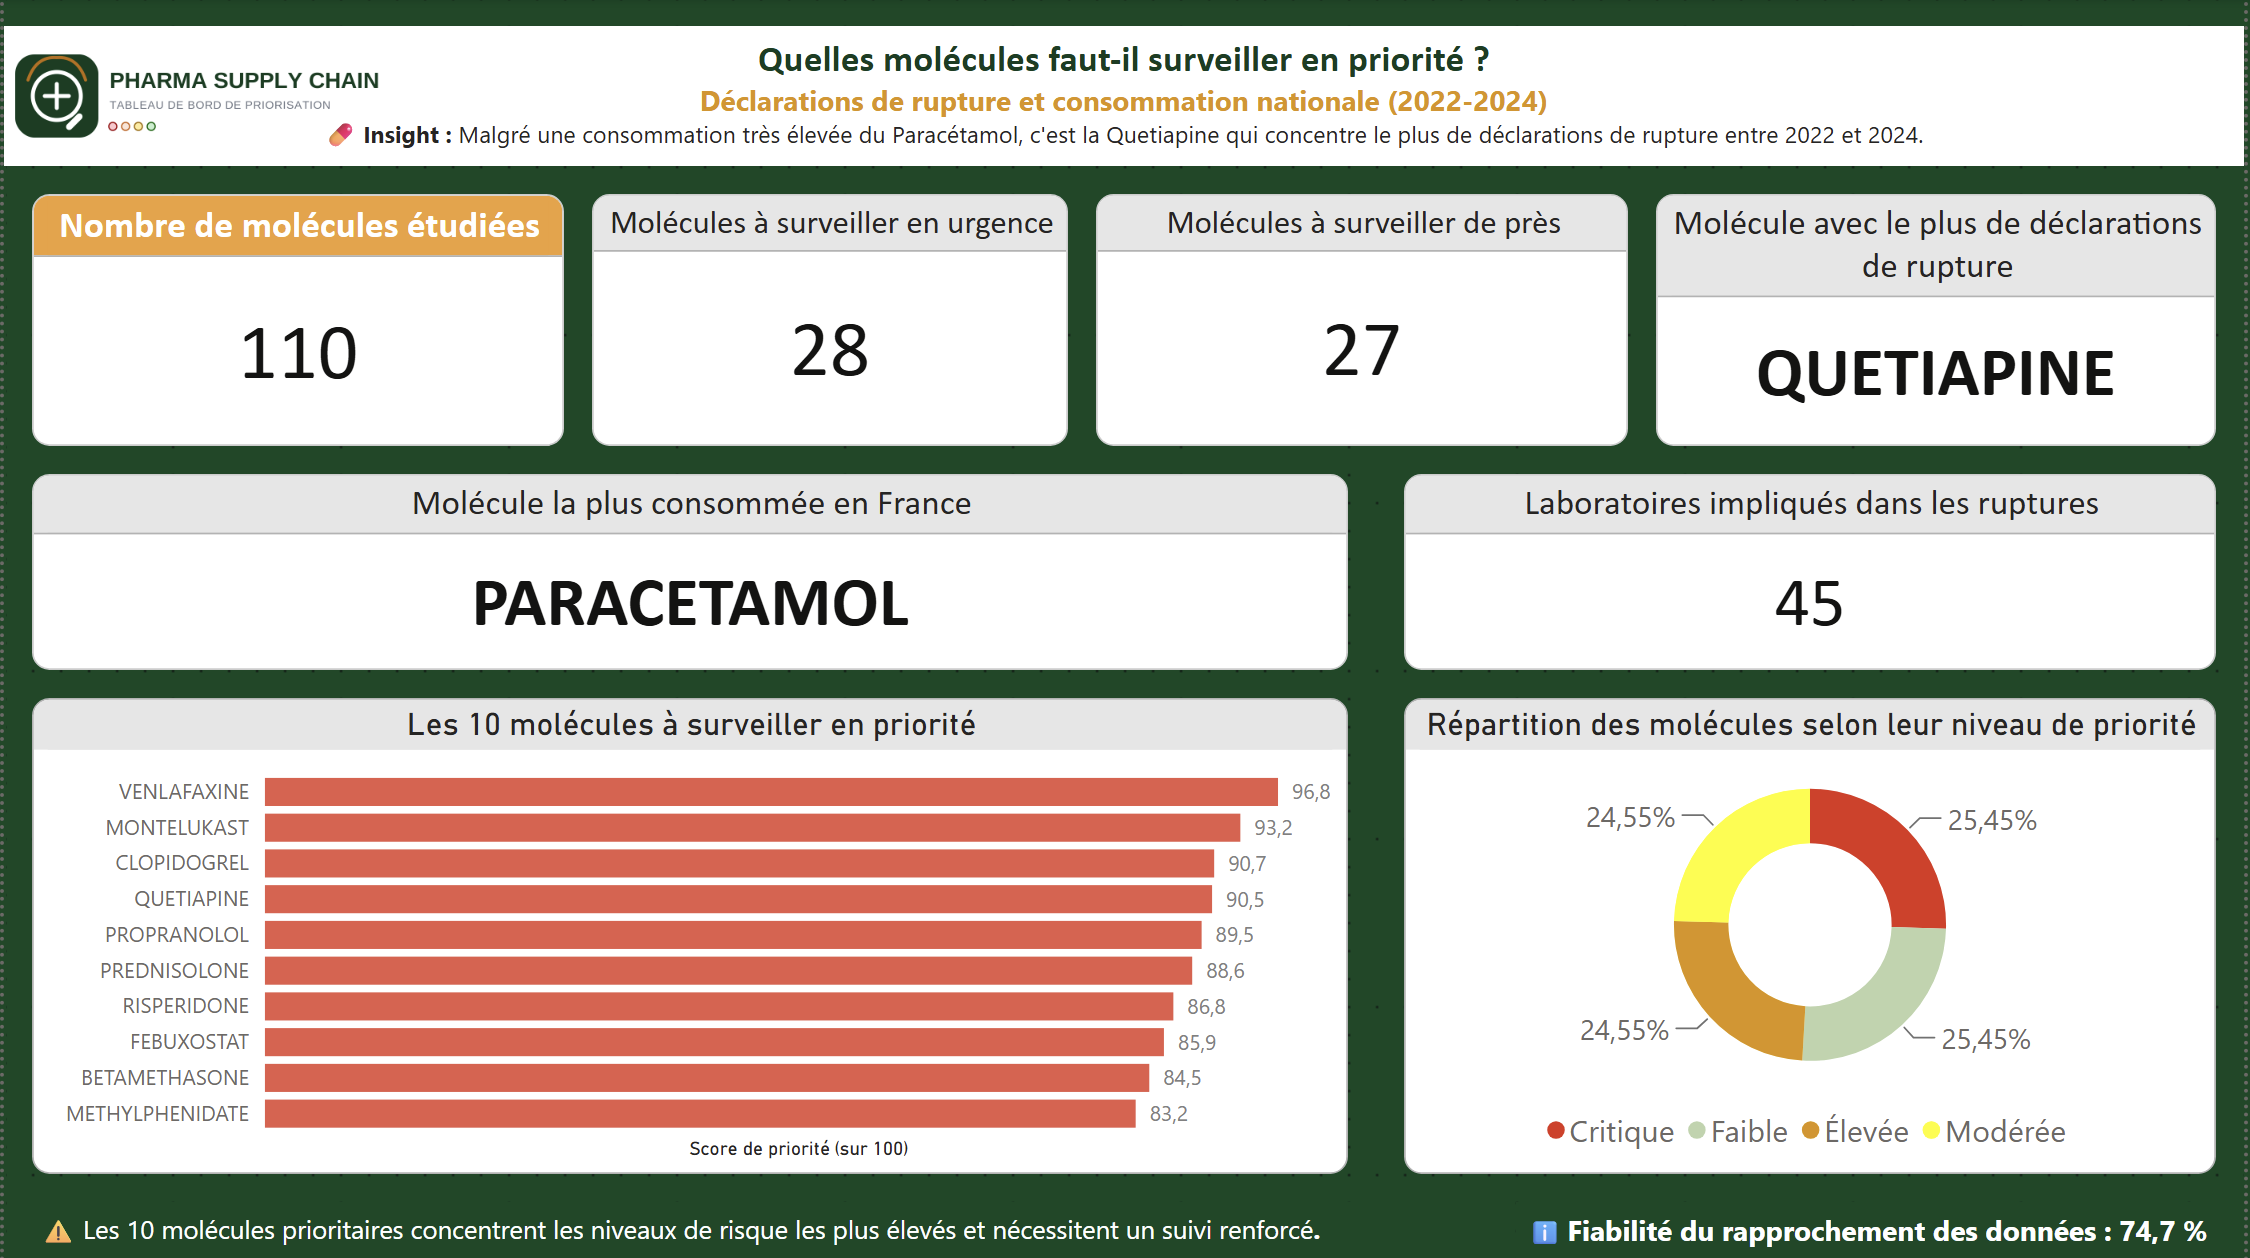
74,7 % des déclarations ont ainsi pu être reliées aux données Open Medic.
À partir de ces données préparées, j’ai construit un modèle en étoile dans Power BI et conçu un dashboard proposant plusieurs niveaux de lecture.
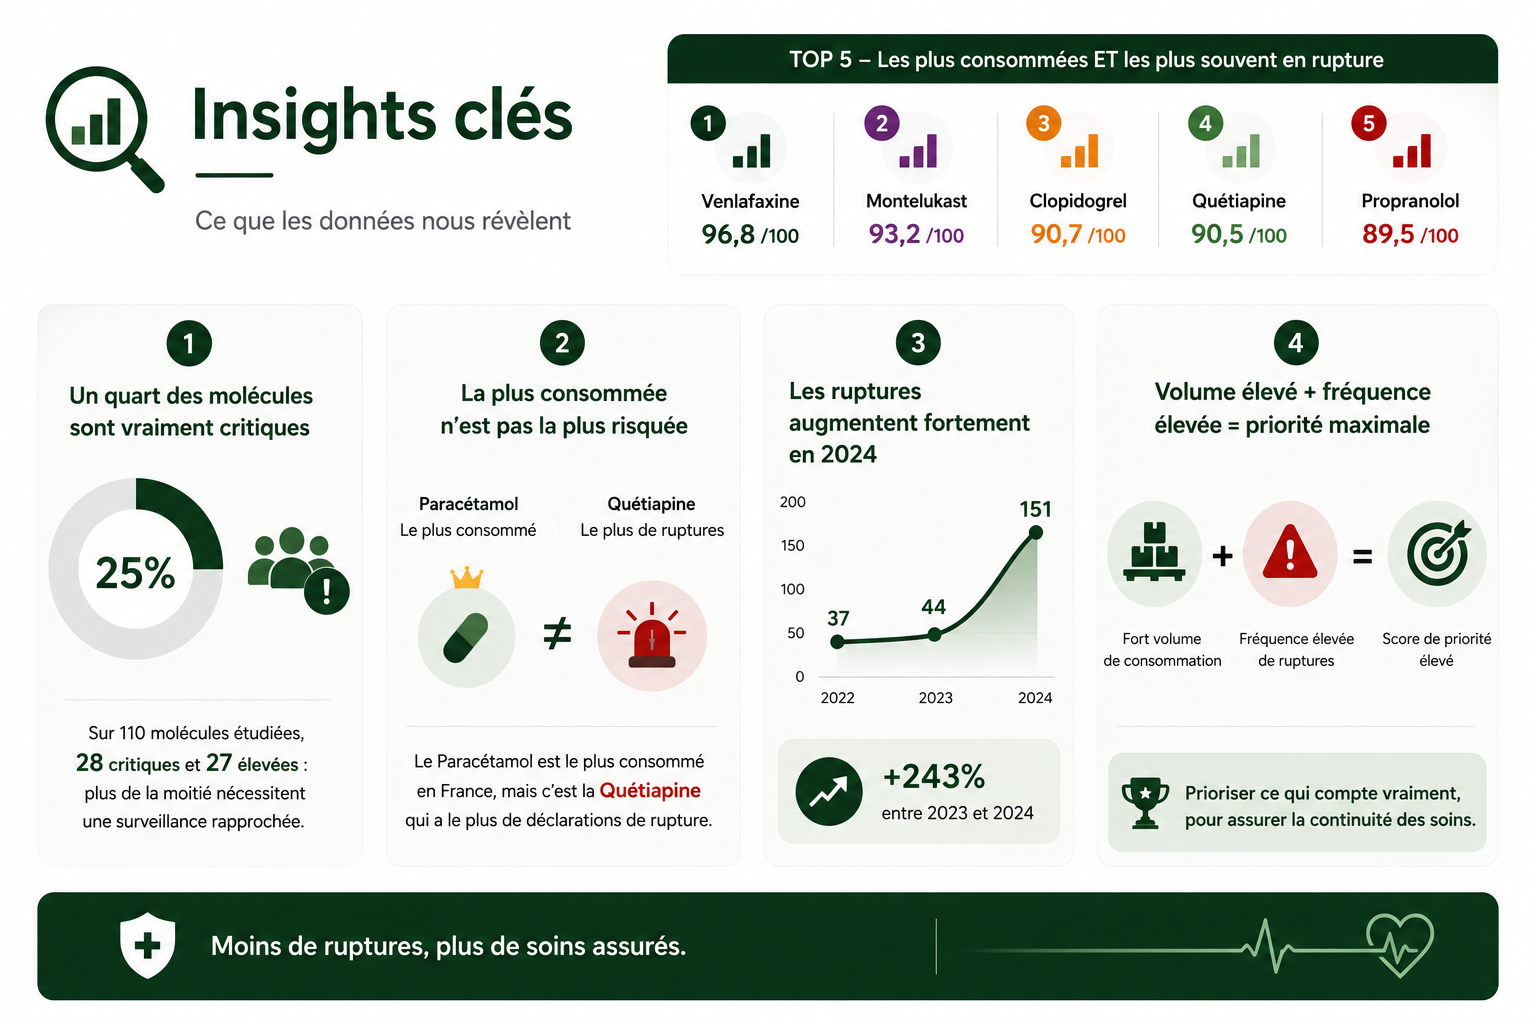
La vue d’ensemble rassemble les résultats essentiels : 110 molécules étudiées, 28 classées dans le groupe de priorité le plus élevé et 45 laboratoires concernés.
Elle permet de repérer les molécules en tête du classement, puis de poursuivre l’analyse pour comprendre leur situation.
Un résultat illustre l’intérêt du projet : dans mon périmètre, le paracétamol est la molécule la plus consommée, tandis que la quétiapine présente le plus de déclarations de rupture.
Ces deux informations montrent pourquoi il est utile de croiser les critères.
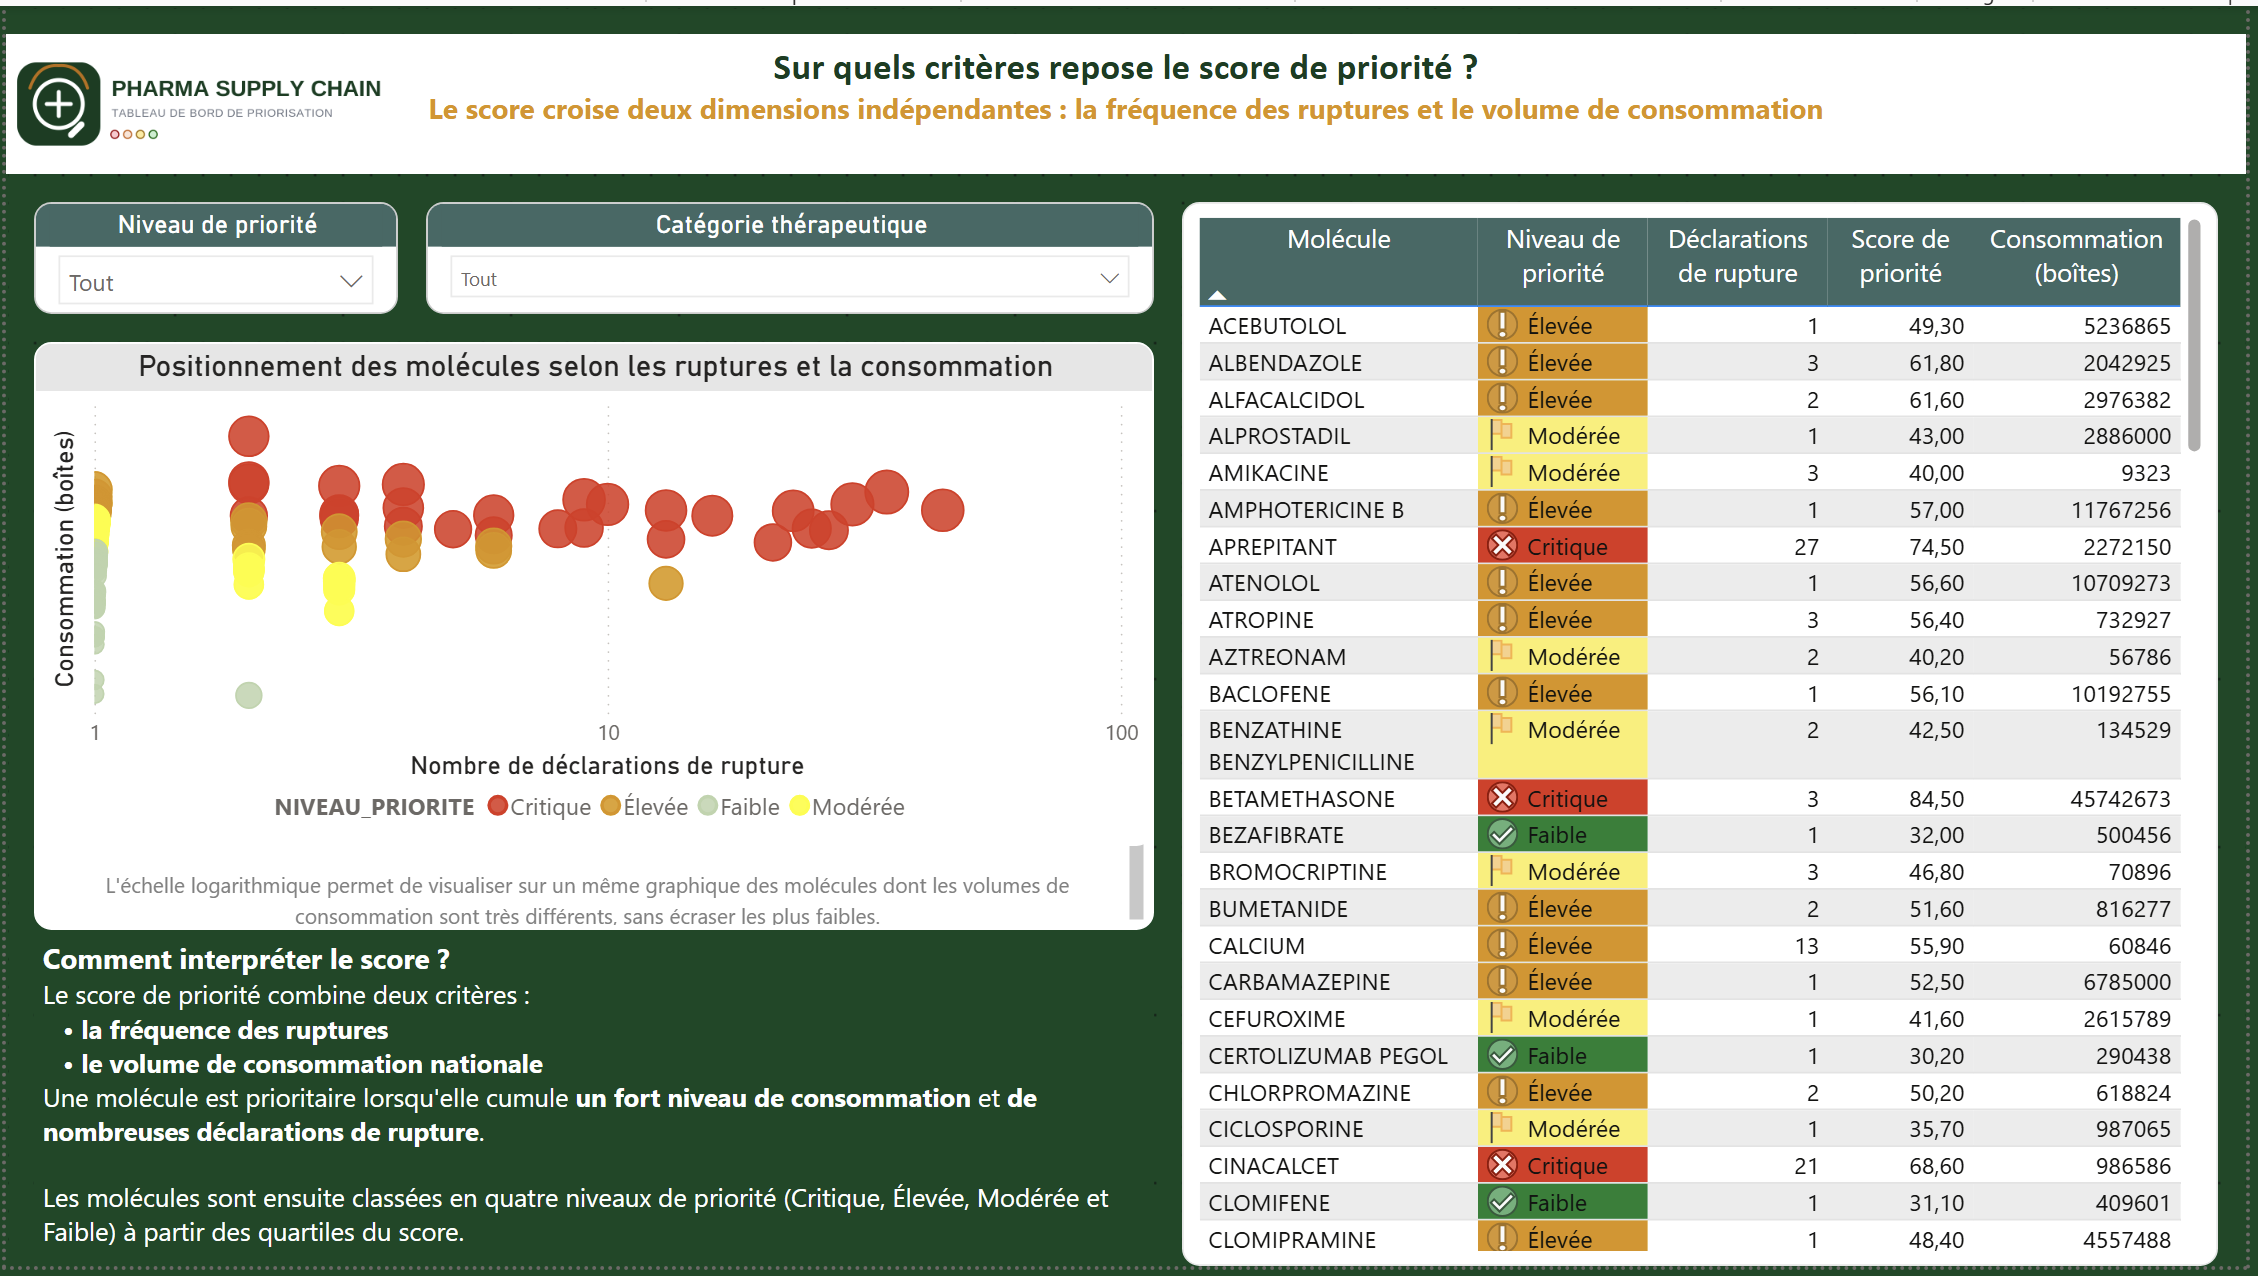
Pour construire le score, j’ai classé les molécules selon chacun des deux critères : fréquence des déclarations et volume de boîtes remboursées.
J’ai ramené ces classements sur une même échelle, puis calculé leur moyenne. Les molécules ont ensuite été réparties en quatre groupes : priorité faible, modérée, élevée et critique.
Le niveau « critique » correspond ici au quart supérieur du classement. Il indique une priorité de surveillance, sans mesurer la gravité médicale d’une rupture.
Cette deuxième vue permet de comprendre le score : le graphique montre la position de chaque molécule selon les deux critères, et le tableau détaille les valeurs utilisées.
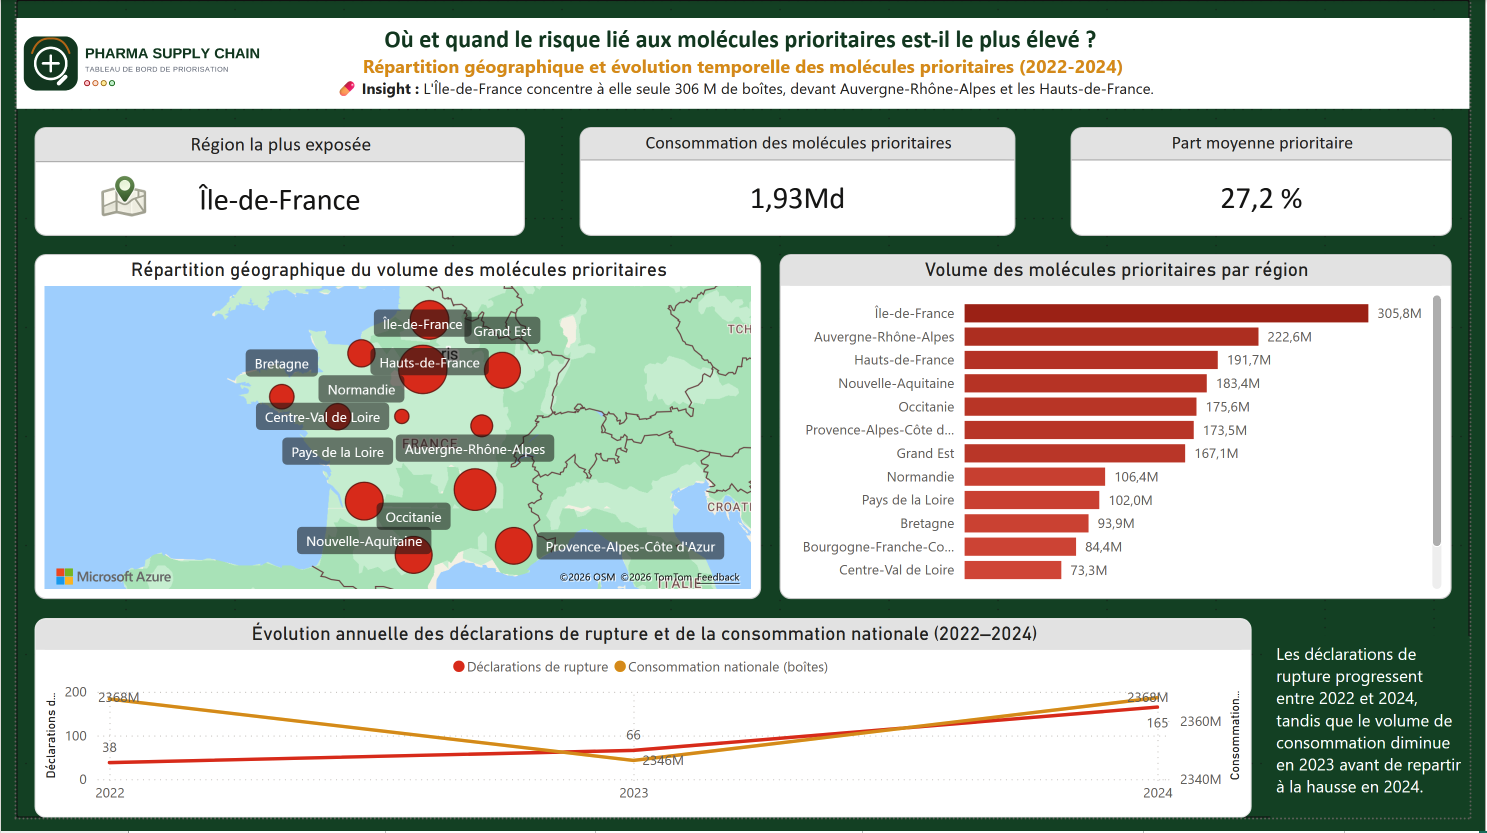
J’ai ensuite exploré la répartition des volumes remboursés entre les régions et l’évolution annuelle des déclarations.
Dans le périmètre étudié, les déclarations passent de 44 en 2023 à 151 en 2024. Cette hausse invite à approfondir les molécules concernées et à suivre leur évolution.
La carte apporte une autre lecture : elle montre où se concentrent les volumes remboursés des molécules prioritaires. Elle représente la consommation régionale, et non la localisation des ruptures.
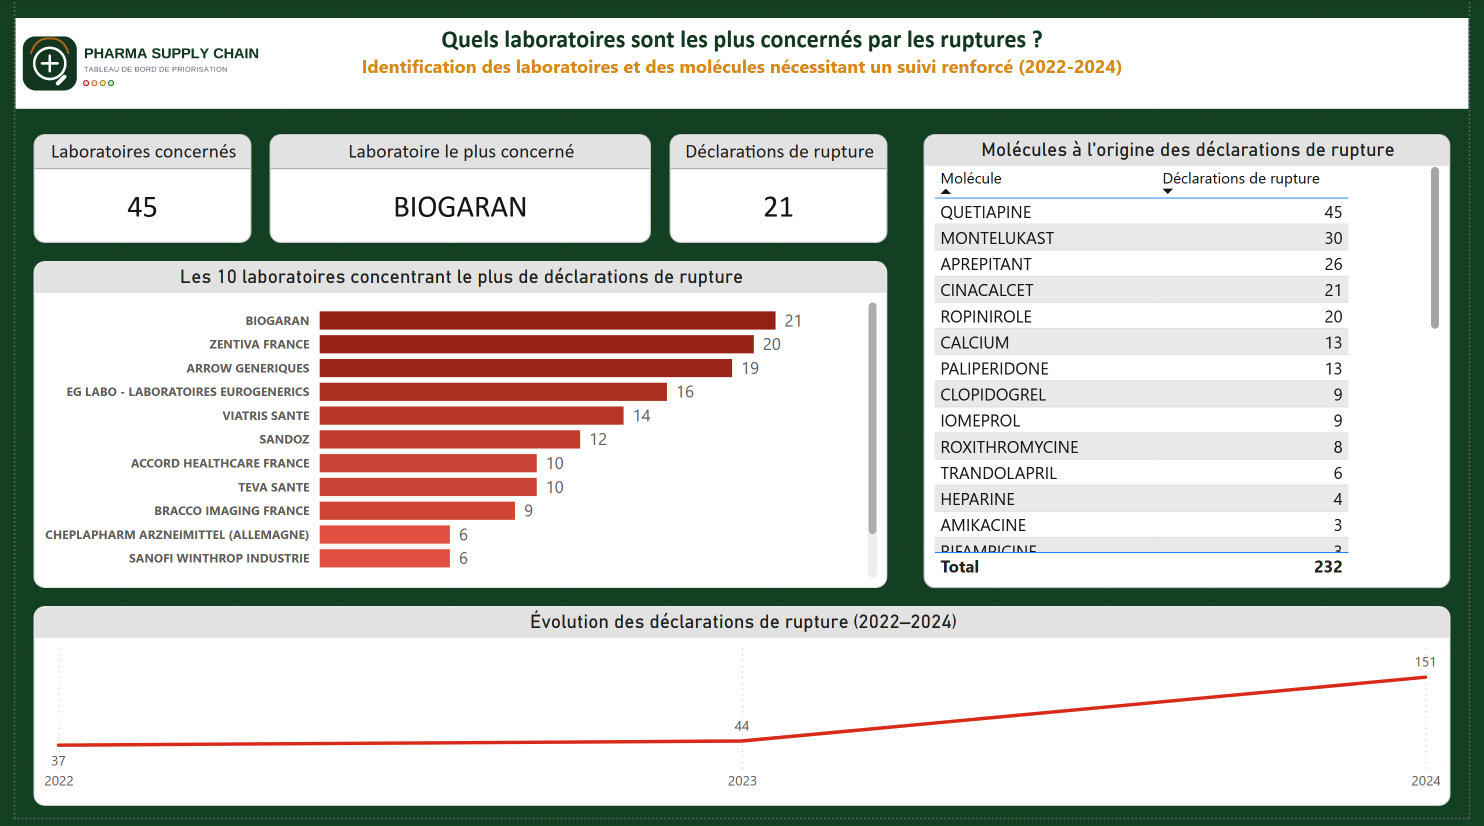
Pour compléter l’analyse, j’ai ajouté une vue consacrée aux laboratoires.
Elle permet de comparer les déclarations qui leur sont associées et d’identifier les molécules concernées.
Cette information peut servir de point de départ pour cibler les échanges et approfondir les situations observées. Le nombre de déclarations reste un indicateur à contextualiser : il ne suffit pas à expliquer les causes des ruptures.
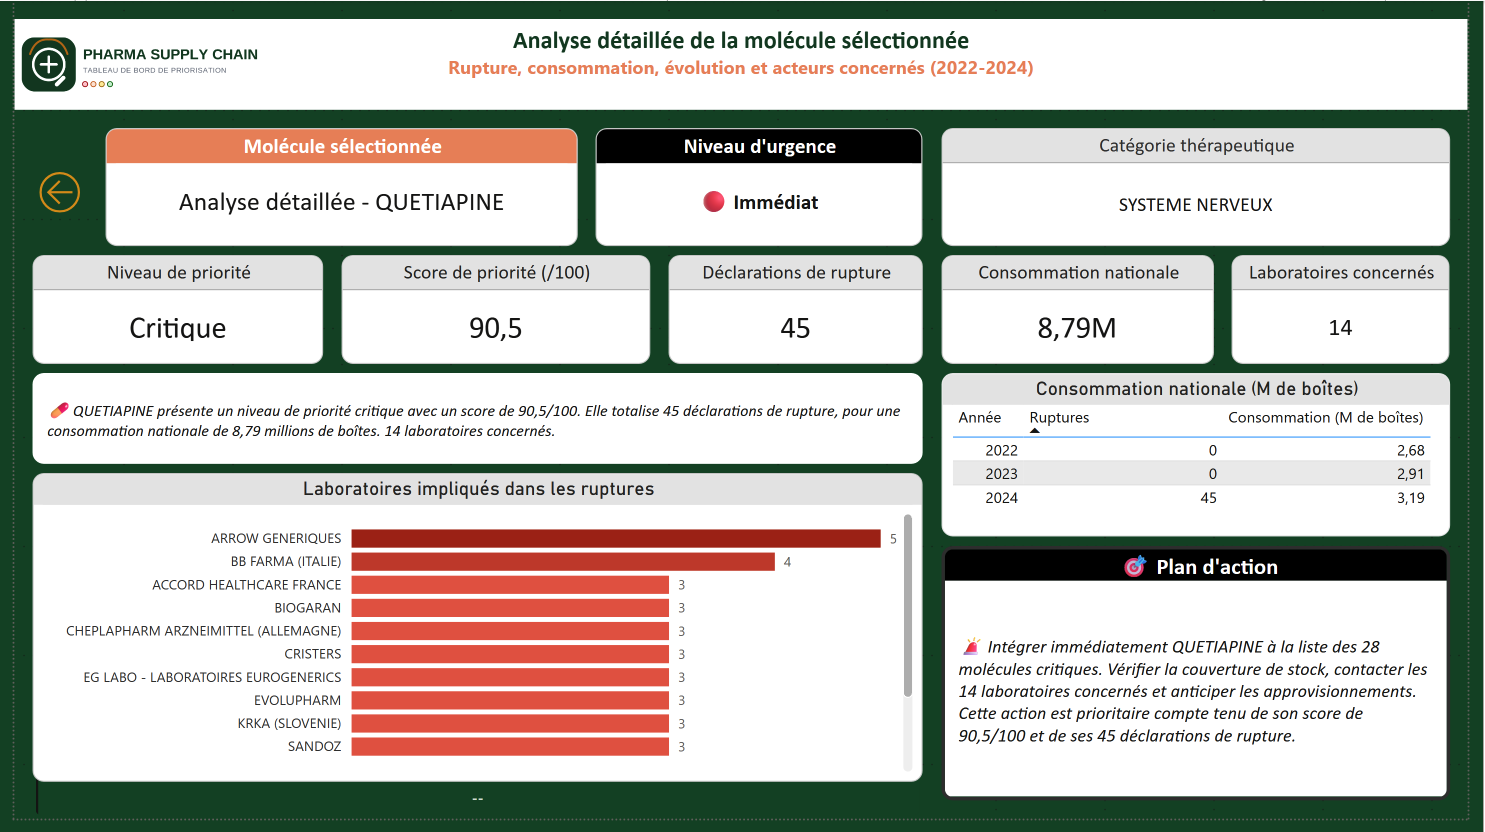
La dernière vue permet d’examiner une molécule en détail. L’exemple présenté est celui de la quétiapine.
Sa fiche rassemble le score de priorité, les déclarations de rupture, les volumes remboursés et les laboratoires concernés.
L’objectif est de pouvoir passer d’une question générale — « quelles molécules surveiller ? » — à une analyse précise de la situation d’une molécule, avec des pistes de suivi.
Mon analyse fait ressortir trois enseignements majeurs :
La fréquence des ruptures ne suffit pas à établir les priorités.
Dans mon périmètre, le paracétamol est la molécule la plus consommée, tandis que la quétiapine présente le plus de déclarations de rupture. Croiser les déclarations et les volumes remboursés permet de construire un classement plus complet.
28 molécules ressortent dans le groupe de priorité le plus élevé.
Ce classement donne une liste précise sur laquelle concentrer la surveillance, plutôt que de suivre les 110 molécules avec la même intensité.
Les déclarations augmentent fortement en 2024.
Elles passent de 44 en 2023 à 151 en 2024 dans les données étudiées. Cette évolution souligne l’intérêt d’un suivi régulièrement actualisé.
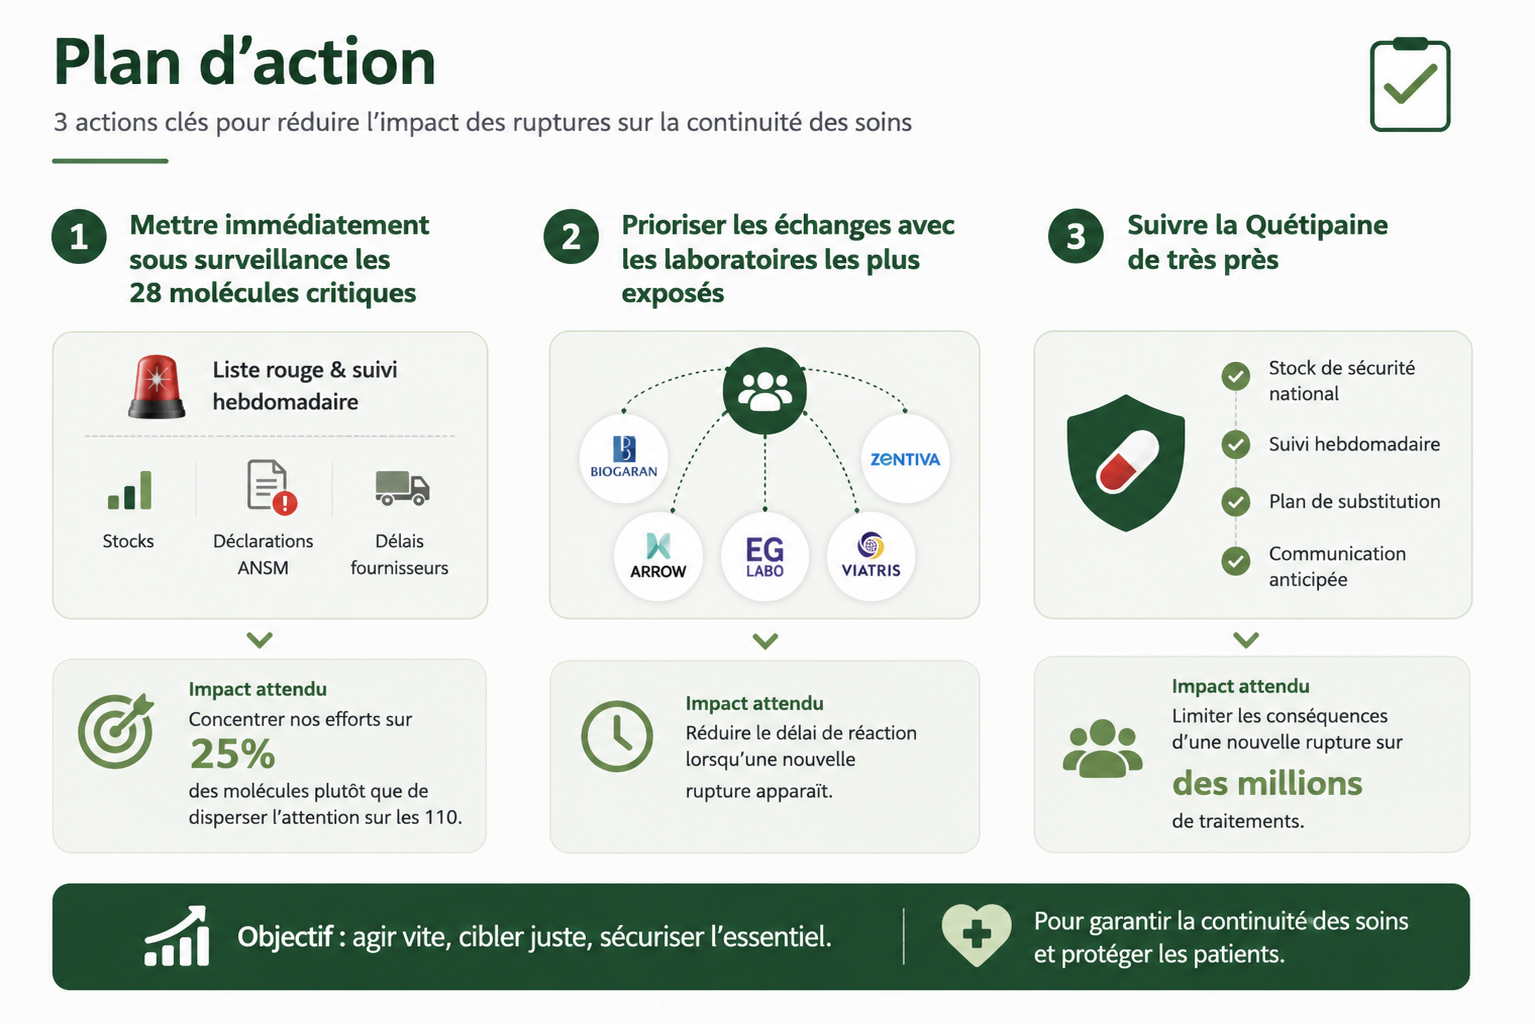
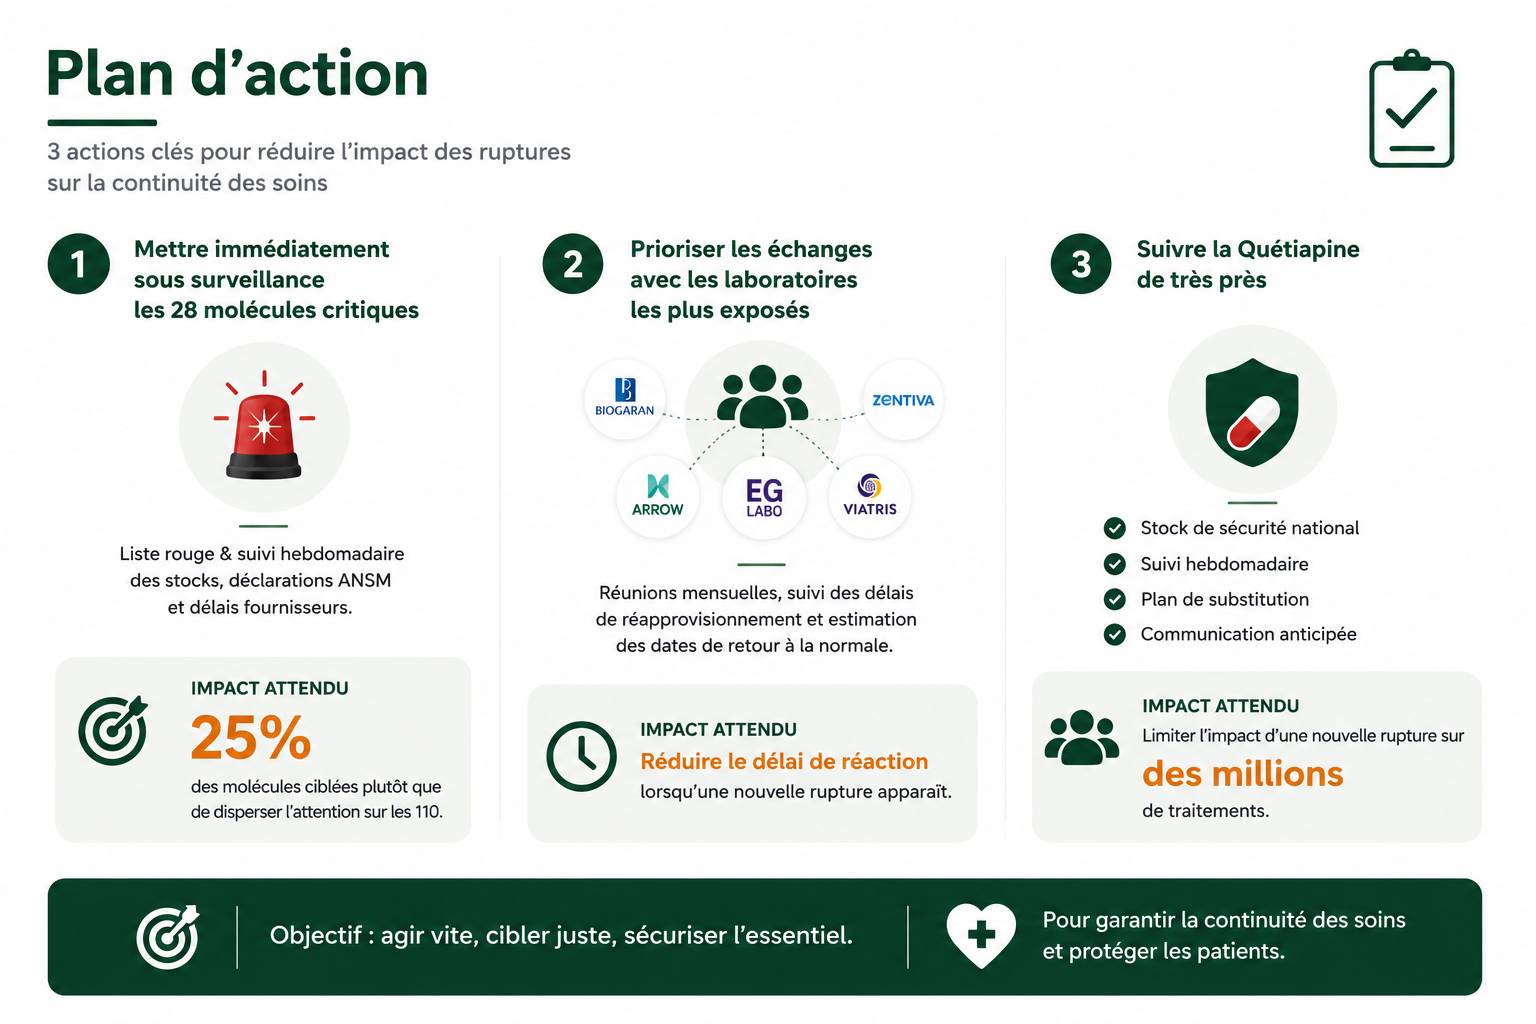
À partir de ces insights, j’ai proposé un plan d’action organisé autour de quatre priorités.
1. Renforcer la surveillance des 28 molécules prioritaires
Constituer une liste de suivi dédiée et examiner l’évolution des déclarations et des volumes remboursés pour repérer les situations qui nécessitent une investigation.
2. Cibler les échanges avec les laboratoires concernés
Utiliser la vue par laboratoire pour préparer les échanges : quelles molécules sont concernées, quelles déclarations se répètent et quelles informations complémentaires faut-il obtenir sur les délais de réapprovisionnement ?
3. Approfondir le suivi de la quétiapine
Cette molécule cumule 45 déclarations de rupture et un score de priorité de 90,5/100. Sa fiche détaillée rassemble les informations nécessaires pour orienter une investigation et préparer un suivi spécifique.
4. Faire évoluer le dashboard vers un outil d’alerte
Actualiser les données, suivre les changements de niveau de priorité et prévoir des alertes lorsqu’une molécule rejoint le groupe le plus prioritaire. Cette évolution permettrait de passer d’une analyse ponctuelle à une surveillance continue.
J’ai transformé trois sources publiques dispersées en un classement argumenté, cinq vues Power BI et un plan d’action ciblé.
Le projet permet de répondre à trois questions opérationnelles : quelles molécules surveiller, pourquoi les prioriser et quels laboratoires contacter pour approfondir leur situation ?
Il démontre ma capacité à mener une analyse complète avec Python et Power BI, à faire ressortir des insights et à les traduire en recommandations concrètes.
Les recommandations restent à valider avec les équipes métier. Le score mesure une priorité de surveillance ; son enrichissement avec la durée des ruptures et des critères cliniques constitue une prochaine étape.